この記事では、「データ活用基盤」について、構成要素の時代による変遷とその背景、現在主流のデータ活用基盤の全体像と各機能の概要を解説します。
<目次>
データ活用基盤の構成要素の変遷
これまでデータ活用基盤は、その機能に対する要求が時代とともに変化するのに伴い、主要な構成要素を大きく変化・発展させてきました。現在に至るまでのデータ活用基盤に対する要求とそれに伴う構成要素の変化は、大きく以下のように整理することができます。
1980年代まで:データウェアハウス(DWH)登場以前
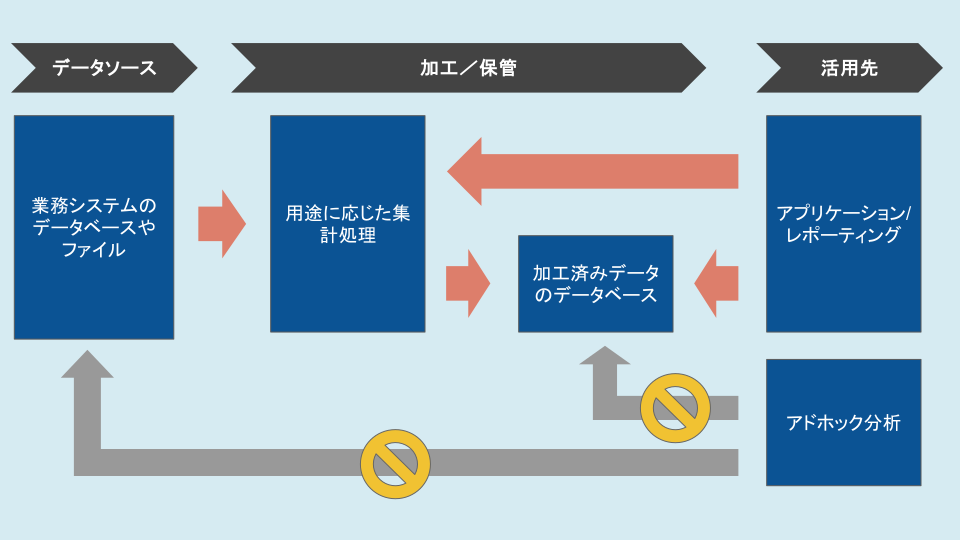
データウェアハウス(DWH、後述)が登場する以前の1980年代までのデータ活用基盤は、業務システム上のデータベースを直接ビジネスアプリケーションやレポーティングなどの用途に使用する、あるいは業務システムで発生したデータを抽出して集計処理など必要な加工を行い、別のデータベースに格納した上で活用先の用途に使用する、という構成が主流でした。
作成:Intelligence In Society
この構成では、「データソースをどのように分析・活用したいか」という活用側のニーズが明らかになった段階で初めて必要なデータが特定され、そこからデータソースに対する抽出・加工などの準備を行う、という手順が取られます。そのため、データ活用のニーズがより高度になっていくに従って、以下のような課題が認識され始めました。
- 活用のニーズが明らかになった段階でデータの準備を開始することによる、リードタイムの長期化
- 特定のニーズに基づきデータを準備するため、既に抽出・加工されたデータを別の用途に対して再利用することが難しい
- 業務システムの安定稼働を優先するため、負荷のかかるアドホックな分析に対して制限をかける必要がある
- 用途の増加に伴い、データ抽出処理の重複や複数の格納先データベースの構築が発生し、費用面や効率性、ガバナンスの面で望ましくない
これらの課題に対する解決策として登場したのが、データウエアハウス(DWH)です。
1990年代~:DWHの登場と普及
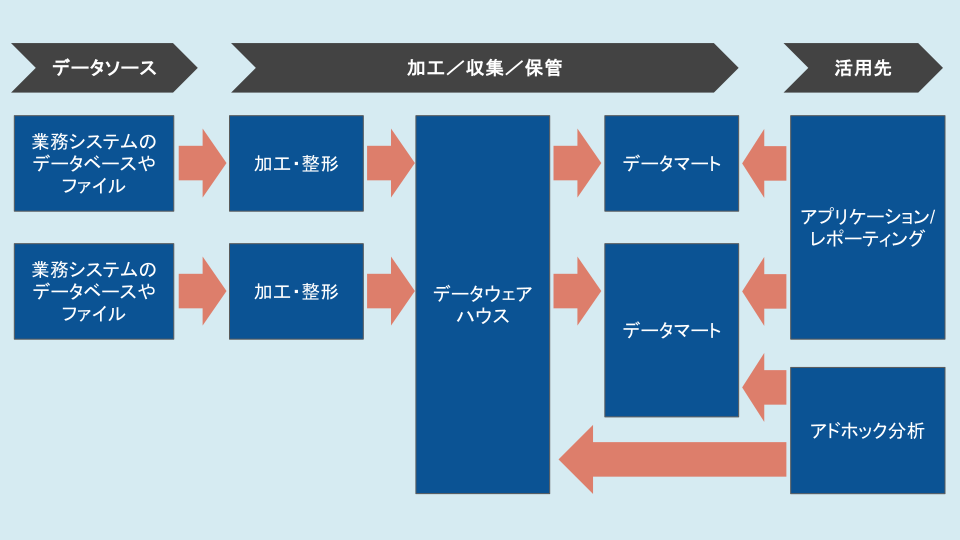
上記のような課題への解決策として考案されたのが、データウェアハウス(Data Warehouse:DWH)で、「データの倉庫」と直訳されます。DWHは、組織内の様々な種類の異なるデータソース(顧客データ、販売データ、在庫データなど)をつなぎ合わせ、分析が可能な形に加工・整形した状態で格納したデータベースです。
DWHが業務システムなどの通常のデータベースと異なるのは、「データの分析」を主な目的としている点です。そのため、目的別や時系別に大量のデータを蓄積でき、通常のデータベースに比べて非常に効率的に検索や集計・分析を行うことができます。また、最新のレコードのみを保持する業務データベースと異なり、DWHでは過去のデータが消去されず蓄積されていくため、時系列の分析などが容易に可能となります。
DWHが登場したことで、様々な業務データベースに分散して保管されていたデータがDWHに集約されるようになるとともに、「活用側のニーズが明らかになった段階で必要なデータが特定され、準備が行われる」というそれまでの手順から、「あらかじめ必要になりそうなデータをDWHに集約しておく」という手順への変化が起きます。
これにより、リードタイムの短縮、データの再利用性の向上、容易なアドホック分析の実施、費用面・効率性・ガバナンスの改善などの可能となりました。
作成:Intelligence In Society
また、DWHとセットで使用されるようになった構成要素にデータマート(Data Mart)があります。データマートはDWH上の大量のデータの一部を特定の利用目的のために事前に抽出・加工した、目的別の小規模なデータベースです。
DWH上のデータを用途に応じて加工・細分化した上でデータマートに格納しておくことで、特定の用途における検索や抽出などに対して高い処理性能を得られるメリットがあり、ビジネスアプリケーションやレポーティングツール、機械学習やAIの活用など、データ活用先のツールと連携して利用されます。
2010年頃:DWHの限界とデータレイクの登場
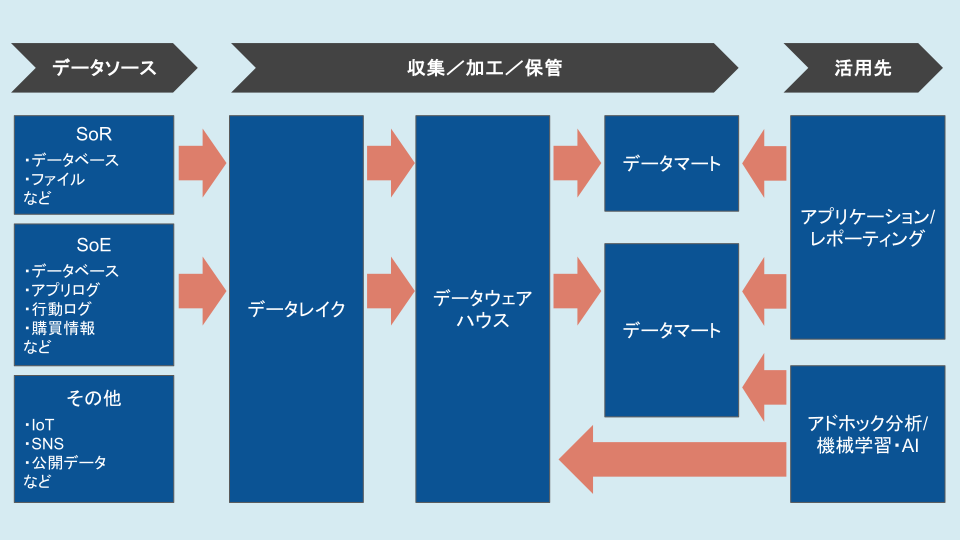
DWHを中心とした上記の構成も、デジタルマーケティングの発展に伴って新たなデータを扱うニーズが拡大する中で、課題が指摘されるようになります。2010年頃からのデジタルマーケティングの拡大により、既存の業務システム(SoR:System of Record)とは別に、顧客との接点(エンゲージメント)を強めるためのシステム(SoE:System of Engagement)によるデータソースが新たに追加されました。
SoEからは、Webサイト上での顧客行動に関する大量のログデータや、顧客の口コミや問い合わせなどの文章や音声、商品ページの画像といった、従来の業務システムが前提とする構造化データ(RDBなど表形式で扱えるデータ)とは異なる非構造化データが新たな種類のデータとして生み出されるようになりました。
SoEから生み出される大量のログデータへの対応や、DWHでは扱うことが難しい非構造化データの拡大は、DWHに依存した構成の機能的な限界を明らかにしました。そして、その解決策として次に登場したのがデータレイク(Data Lake)です。
データレイクの登場により、SoEから生み出さる大量のデータや非構造化データをデータレイクに保管し、その中から必要なデータを抽出・加工した上でDWHに格納する、といった活用が可能となりました。
作成:Intelligence In Society
2020年頃:レイクハウスの登場
データレイクの登場により、非構造化データなどを取り扱うことが可能となった一方で、データレイクとDWHを別々に運用することに伴う以下のような課題も明らかとなってきました。
- 同じデータをデータレイクとDWHに別々に保管することによる、容量・費用面の非効率性
- データレイクのデータを加工した上でDWHへ格納するパイプラインを開発運用するコストやリードタイム
- ファイル形式のデータレイクとテーブル形式のDWHを個別に管理することに伴うガバナンスの複雑化
このような課題への解決策として2020年頃に登場し注目されている新しい機能が、レイクハウス(Data Lakehouse、データレイクハウス)です。レイクハウスはデータレイクが持つ「安価で柔軟な保管庫」という特性と、DWHが持つ「高い機能と信頼性」という特性を融合させたものです。
レイクハウスを活用することで、大量のデータを安価な保管庫に置いたまま、高い集計・分析機能の利用や非構造化データに対する機械学習の適用などを実現することが可能になると考えられています。
データ活用基盤の全体像
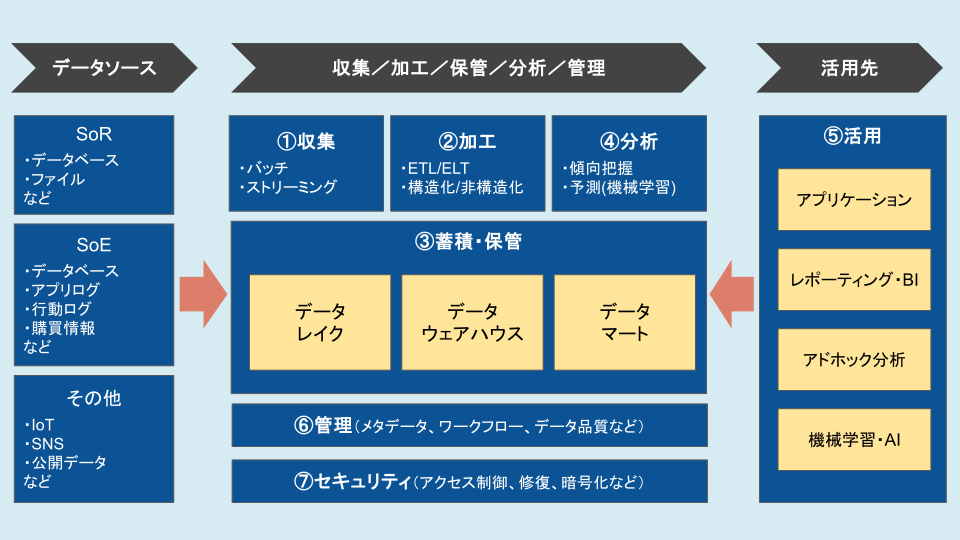
ここまで、データ活用基盤の主要な構成要素が時代とともにどう変化してきたかを解説しましたが、データ活用基盤はこれらの構成要素の他に、データの管理やセキュリティに関わる機能なども含めて全体が構成されます。データ活用基盤の全体像を図で示すと、下図のようになります。
作成:Intelligence In Society
①収集
バッチ処理/ストリーミング処理
業務システムのデータベースやSoE、SNSなどの多様なデータソースからデータを収集する機能で、その形式は大きくバッチ処理とストリーミング処理の2種類に分けられます。バッチ処理は予め決められたタイミングにデータを一括で収集する方法で、データソースからデータレイクへのデータの受け渡しは、一般的には日単位や時間単位のバッチ処理で連携されます。
一方、位置情報などのリアルタイムのデータを利用するアプリケーションなどでは、ストリーミング処理が行われます。ストリーミング処理は、何かしらのイベントの発生をきっかけとして、データを数秒単位の短い間隔ですぐに処理する方法で、バッチ処理と異なりレコード単位で処理を行います。バッチに比べより短いスパンでの処理を行うため、実装や運用の難易度は高くなります。
また、ストリーミング処理の一種であるCDC(Change Data Capture)では、データソースの変更をDWHなどに(ほぼ)リアルタイムに反映させることで、限りなく最新のデータをもとに分析などを行うことが可能となります。バッチやストリーミングなどのデータ収集の方法は、データをどのように利用するのかに応じて最適なものが選択されます。
②加工
ETL/ELT
データソースから収集したデータを分析などにより適した形に加工・整形し、DWHやデータマートに格納します。これには主に、ETL(Extract-Transform-Load)とELT(Extract-Load-Transform)の2つの方法があります。
両者の違いは、抽出(Extract)したデータに対して、変換処理(Transform)とDWHなどへの取り込み(Load)を行う順序です。
- 【ETL】:抽出(Extract)したデータに対して、先に変換処理(Transform)をしてからDWHなどに取り込む(Load)
- 【ELT】:抽出(Extract)したデータを、先にDWHなどに取り込んで(Load)から変換処理(Transform)をする
構造化データ/非構造化データ
対象のデータが構造化データであるか、非構造化データであるかは、データ加工の難易度や有効性に大きく影響します。特に、データの構造が予め定義されていない非構造化データの加工や整形には、従来の構造化データの処理方法とは異なるアプローチが必要となります。
非構造化データのうち、JSONやXMLなどの一定のルールを持つ形式で保存されたデータは、ルールに基づく規則性を利用して表形式の構造化データに変換し、処理することができます。一方、メール文章やPDF、画像や動画、音声などの非構造化データはルールに基づく変換ができません。これらのデータに対しては、自然言語処理や画像処理などの専門的に訓練された機械学習モデル(AI)を利用したアプローチが必要となります。
③蓄積・保管
加工・整形や抽出の有無などが異なる状態のデータを蓄積・保管する機能で、データの状態や目的に応じてデータレイク、データウェアハウス(DWH)、データマートなどが保管先として選択されます。上述の通り、近年はデータレイクとDWHの2つを別々に用意する代わりに、レイクハウスを活用するケースも増えています。
DWHやデータレイクは、コスト効率の高さや規模拡大に対する拡張性の高さ、運用の容易さなどからクラウド型が現在の主流となっており、DWHではGoogle BigQuery、Amazon Redshift、Snowflakeなど、データレイクではGoogle Cloud Storage、Amazon S3などのクラウド型サービスが広く利用されています。
④分析/⑤活用
DWH上のデータに対して直接、検索や集計、統合などの処理を行うことでデータの持つ傾向を把握したり、DWHからデータマートに抽出したデータをビジネスアプリケーションやレポーティング、BI(ビジネスインテリジェンス)などの活用先に連携することで、データの分析・活用を行います。
近年では、DWH上のデータに対して機械学習モデルを直接適用し、データをもとにした予測などを行う処理もDWHの機能として実装されており、機械学習モデルやAIを利用した高度な分析を、DWH内でより簡単に実施できる環境が整ってきています。
例えばGoogle BigQueryなどは、DWHとデータレイクの連携を容易にするレイクハウスとしての機能や、データのリアルタイム分析、機械学習モデルの作成などの幅広い機能を提供しており、実質的には単なるDWHではなく、アナリティクス・レイクハウス(Analytics Lakehouse)としての位置づけを持っています。
⑥管理
データを適切な状態に維持・管理するための機能で、メタデータ管理やワークフロー管理、データ品質管理などが含まれます。
メタデータ管理
メタデータとはデータ活用基盤で管理されているデータに関するデータを意味し、メタデータ管理によって「どこにどのようなデータがどう存在しているか」という情報を管理します。
データ活用基盤で管理するデータの規模が大きくなるに従い、そのデータがどこから来たのか、目的に合致したデータはどこにあるのか、などを確認する上で、メタデータ管理が重要となります。メタデータ管理には、テーブルやカラム(列)の定義や属性、データに対するアクセス権限(後述)、データ同士のつながり(データリネージュ)などの他に、それらの変更履歴などが含まれます。
ワークフロー管理
データがデータソースから収集され、加工や整形などの処理、あるいは機械学習モデルの適用などを経た上でDWHやデータマートに保管されるまでの一連の処理の集合は、データパイプラインと呼ばれます。このデータパイプライン内の各処理の依存関係や順序などを適切な状態に保つための管理がワークフロー管理で、上述のETL・ELTなどに対する管理ものその一部に含まれます。
⑦セキュリティ
データのセキュリティに関する機能で、アクセス制御、データの修復、データの暗号化などの機能が含まれます。
アクセス制御
アクセス制御は、特定のユーザーのデータに対する権限を「読み取りが不可」「読み取りが可能」「読み取りに加えて書き込みや変更も可能」などに管理することです。
アクセス制御の方法には主に、ID/パスワードやクライアント証明書によってログインできるユーザーを識別する「認証」と、役職・所属組織といったユーザーの属性情報(メタデータ)や、管掌部門・個人情報有無などのデータの属性情報を利用してアクセスの条件を規定する「認可」があります。多くのDWHでは、データセットやテーブル単位に加えて、テーブルの行や列単位でアクセス条件を設定することができます。
データ修復
サーバーの障害や大規模な災害、オペレーションミスなどが発生した際に、データが失われないようにする、あるいは失われたデータを修復する機能もデータ活用基盤の重要な要素です。近年のクラウド型のDWHでは、データが自動で複製され複数のサーバーに保持されるため、特定のサーバーの障害や地域限定的な災害に対しては、データが失われない仕組みとなっています。
また、オペレーションミスによるデータ損失に対しては、特定のテーブルを過去数日内の任意の日時の状態に戻すことができる機能や、テーブルのある時点の状態をスナップショットとして残すことができる機能などが用意されており、これらをうまく活用することで、データの修復を高い確率で実現することが可能となります。
ここまで、「データ活用基盤」について、構成要素の時代による変遷とその背景、現在主流のデータ活用基盤の全体像と各機能の概要を解説しました。
当記事に関連するトピックについての詳細は、以下のページをご覧ください。
また、データ活用・データ分析に関する全ての記事は以下のページからご覧いただけます。
参考文献:
◦饗庭秀一郎、他 (2025) 『改訂新版 Google Cloudではじめる実践データエンジニアリング入門』技術評論社
◦大川真輝 (2023) 『DX時代のデータマネジメント大全 ― DX、データドリブン経営、データ利活用から理解する ―』