この記事では、「回帰」と「分類」について、それぞれの目的・相違点やユースケース、主な評価指標を具体例をもとに解説します。
<目次>
回帰と分類:それぞれの目的と相違点
「回帰 (regression)」は統計学や計量経済学、機械学習など多くの領域で使用される言葉です。統計学や計量経済学では「ある変数を他の変数で説明する分析」を全て含めて「回帰分析」と呼ぶことが一般的です。一方、機械学習では、あるデータにおいて「何かしらの変数の数値を予測あるいは推定すること」を、「回帰」と呼びます。
一方、「分類 (classification)」は主に機械学習の領域で使用される言葉で、ある集団の各個体(構成要素)がどのクラス(カテゴリー)に分類されるかを予測することを指します。特に、2つのクラスに分類する場合を「二値(2クラス)分類」、複数のクラスに分類する場合を「多値(多クラス)分類」と呼びます。
・ある変数を他の変数で説明する分析全て(統計学・計量経済学)
・あるデータにおいて何かしらの変数の数値を予測あるいは推定すること(機械学習)
分類:
・ある集団の各個体がどのクラスに分類されるかを予測すること(機械学習)
回帰と分類を「説明変数」と「目的変数」の2つの関係を使い整理すると、回帰は説明変数と「連続的な目的変数」の関係を学習し、学習した関係性をもとに目的変数の値を説明変数によって説明する(統計学や計量経済学)、または説明変数の値から目的変数の値を予測する(機械学習)ものです。
一方、分類は説明変数と「離散的な目的変数」の関係を学習し、学習した関係性をもとに説明変数の値から目的変数の値を予測するものです。
また、機械学習における「予測」においては、何かが「どの程度起こるか」を予測するものが回帰、何かが「起こるかどうか」を予測するものが分類、と整理できます。
| 回帰 | 説明変数と連続的な目的変数の関係を学習 | 何かが「どの程度起こるか」を予測 |
| 分類 | 説明変数と離散的な目的変数の関係を学習 | 何かが「起こるかどうか」を予測 |
なぜ「回帰」と呼ぶのか
ここで、ある変数を他の変数で説明したり、数値を推定したりする分析をなぜ「回帰」と呼ぶのか、疑問を感じる方もいるかと思います。これは、最も最初に行われた回帰分析の応用事例が、「平均への回帰 」という現象に関するものであったことに由来します1。
回帰分析の生みの親とされるフランシス・ゴールトンは、父親の身長と息子の身長の関係を分析した1886年の論文で、息子の身長は父親の身長よりも平均身長に近づく傾向がある(2つの値の関係を表した直線の傾きが1より小さくなる)ことを示し、これを「平均への回帰」と呼びました。
これがもととなり、現在の統計学などでは「平均への回帰」に限らず、ある変数を他の変数で説明する全ての分析が、「回帰分析」と呼ばれています。
ユースケースと代表的なモデル
回帰(値の説明)
説明を目的とした回帰分析は、ある結果を生じさせた要因をモデルとして表現することで、ある結果に対して各要因がどの程度影響していたのか、本当に影響していたのか、といったことを分析します。
例えば、先ほどの身長の例では、以下のような回帰式で目的変数(子の身長)と説明変数(親の身長)の関係をモデル化し、データからβの値を求めることで、親の身長が子の身長に与える影響を数値化します。また、「親の身長による影響 (β) は0である」という帰無仮説に対する仮説検定を行うことで、親の身長が子の身長に有意に影響することを証明します。
なお、上記のような、説明変数が一つのモデルを「単回帰分析」、説明変数が2つ以上のモデルを「重回帰分析」と呼びます。
計量経済学(因果推論)では、「回帰」の名前が付く分析手法の一つに回帰非連続デザインがありますが、回帰非連続デザインでは、ある処置(介入)の対象となるか否かを変数の一つとして表現した重回帰モデルを用いて、処置の有無を決定する閾値周辺での処置効果の有無や大きさの分析を行います。
回帰(値の予測・推定)
機械学習において予測・推定を行う回帰は、「ある寄付者がどのくらいの金額を寄付してくれるか」といった金額や、サービス使用量の予測などにおいて多く使われます。
例えば、ある団体で寄付金を集めるためのプロモーションを行うため、団体のニュースレターへの登録者を対象に、年齢と収入の情報をもとにプロモーションによる寄付金額を予測するケースでは、学習データをもとに以下のような線形回帰モデルを学習し、最も精度の高い予測を行う各wの値を求めます。
機会学習でよく使用される他の回帰モデルには、過学習 (overfitting) を回避するための正則化 (regularization) を行うLasso回帰・Ridge回帰と呼ばれるものや、ロジスティック回帰などがあります。
ロジスティック回帰は、重回帰分析のような一般的な線形回帰にロジスティック(シグモイド)関数と呼ばれる関数を適用し、予測値が取る範囲を0~1に制限することで、確率の予測を可能とするモデルです。
分類
機械学習における分類は、1か0か、AかBかCか、といったクラスを予測するケースで行われます。先ほどの寄付金を集めるプロモーションの例では、「ニュースレターの登録者のうち、プロモーションに反応して寄付をしてくれるのは誰か」を予測するため、対象者を「寄付する/しない」の2つのクラスに分類します。
ロジスティック回帰は、線形回帰モデルで得られる値を「確率」を表す別の表現方法に変換するモデルのため、このような分類を行うケースでも使用することができます。その場合、予測した確率値が0.5未満であれば「寄付しない」、0.5以上であれば「寄付する」というクラス分類を行います。
分類に使用されるその他の代表的なモデルには、スパムメールの検出に使用されるナイーブベイズや決定木系のモデル、ニューラルネットなどが挙げられます。特に決定木系のモデルは、他のモデルに比べて分類のルールを分かりやすい形で得られる点や、アンサンブル学習によってモデルの精度を高めやすい点などから、最も広く使われるモデルの一つです。
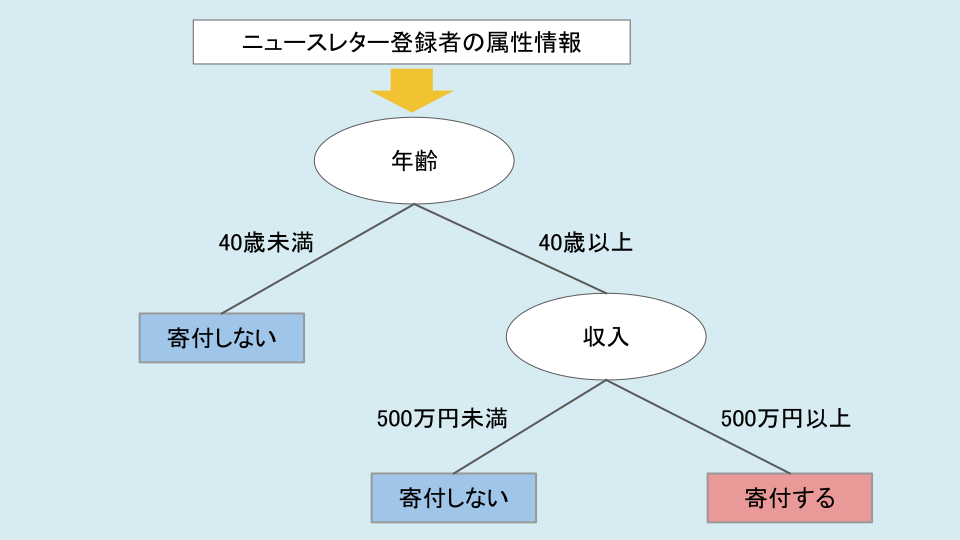
「寄付をするか否か」を予測する決定木の例
タスク別の主な機械学習手法についての詳細は、以下の記事をご覧ください。
使用される主な評価指標
回帰における評価指標
実際の値と推定値の差を「誤差」と呼びますが、回帰モデルにおける評価指標は大きく、誤差の大きさに関する評価指標(RMSE、RMSLE、MAE、R2など)と誤差率に関する評価指標(MAPEなど)の2種類に分けることができます。以下では、誤差の大きさに関する評価指標のうち、特によく用いられるRMSEとR2の概要を解説します。
RMSE (Root Mean Squared Error:平均平方二乗誤差)
RMSEは、目的変数について実際の値と推定値の各セットにおける「差の二乗」を計算し、それらを平均した上で平方根をとることで得られます。値が小さい(実際の値と推定値の誤差が小さい)ほど、精度が高いと評価されます。
※各記号は、N:サンプル数、yi:i番目のサンプルの実際の値、yi (ハット):i番目のサンプルの推定値、を表します。
なお、外れ値の影響を受けやすいという特徴があるため、RMSEを目的関数として機械学習を行う場合には、モデルが外れ値に過剰に適合した学習をしてしまう可能性に注意が必要です。
R2 (決定係数)
R2は、回帰モデルによる推定結果が、実際のデータにどの程度当てはまっているか(回帰モデルの当てはまりの良さ)を表す指標です。
「予測値で説明される変動」の「全変動」に対する比率として計算され、回帰モデルが、実際の値に対してどれだけの説明能力を持っているかを0 ~ 1の数値で表現します。数値が1に近いほど当てはまりが良く、高い精度の推定を行っていることを意味します。
※y(バー)は、目的変数の実際の値の平均値を表します。
分類における評価指標
分類タスクの評価指標を定義する際に重要となるのが、混同行列 (confusion matrix)です。混同行列は、予測値と実際の値との関係を以下の4区分に整理した上で、それをマトリクス上に表現したものです。
- TP:真陽性(True Positive) ― 陽性と予測し、その予測が正しい場合
- FP:偽陽性(False Positive) ― 陽性と予測し、その予測が正しくない場合
- TN:真陰性(True Negative) ― 陰性と予測し、その予測が正しい場合
- TP:偽陰性(False Negative) ― 陰性と予測し、その予測が正しくない場合
| 実際の値=陽性 | 実際の値=陰性 | |
| 陽性と予測 |
TP: |
FP: |
| 陰性と予測 |
FN: |
TN: |
以下ではこの混同行列の表現を用いて、二値分類における主な評価指標のうち、正答率と適合率・再現率の概要を解説します。
正答率 (accuracy)
正答率は全ての予測のうち、正しい予測の割合を表し、「精度」とも呼ばれます。混同行列の要素を用いた表現では、正しい予測数を全予測数で割ったものとして表されます。
正答率はその分かりやすさから広く使用される一方、以下のような問題点があるため、使用においては十分な注意が必要です。
①不均衡なデータにおける評価:
例えばWEB広告のクリック率のように、陽性となる(クリックされる)確率が非常に低い予測対象では、単純に「全て陰性」と予測することで99%以上の非常に高い正答率を出すことができますが、当然このような予測モデルには意味がありません。
②偽陽性と偽陰性の区別:
正答率では偽陽性によるエラーと偽陰性によるエラーが区別されず、それぞれのエラーが同じ重要度として評価されます。しかし現実には、例えば癌検診のように、癌が見過ごされることを意味する「偽陰性」は「偽陽性」よりも深刻であり、より重大な意味を持ちます。
適合率 (precision)・再現率 (recall)
「適合率 (precision)」は、陽性であると予測されたものが実際にどのくらい陽性であったかを測定するもので、「陽性的中率 (PPV : positive predictive value)」 とも呼ばれます。適合率とセットで用いられる「再現率 (recall)」は、実際に陽性のサンプルのうち、陽性と予測されたものの割合として表されるもので、「真陽性率」と同じことを意味します。
「適合率」は、誤って陽性であると予測してしまうケース(偽陽性)を制限したい場合にその指標として重視されます。一方、「再現率」は、陽性のサンプルを誤って陰性と予測してしまうケース(偽陰性)を避けたい場合に重視されます。適合率と再現率はトレードオフの関係にあります。
回帰・分類における評価指標には、これら以外にも様々なものが使用されています。ここで解説したもの以外の評価指標に関する詳細は、以下の記事をご覧ください。
ここまで、「回帰」と「分類」について、それぞれの目的・相違点やユースケース、主な評価指標を解説しました。
当記事に関連するトピックについての詳細は、以下のページをご覧ください。
また、データ分析・因果推論・機械学習に関する全ての記事は以下のページからご覧いただけます。
出典:
1. 西山慶彦・新谷元嗣・川口大司・奥井亮 (2019) 『計量経済学』有斐閣
参考文献:
◦西山慶彦・新谷元嗣・川口大司・奥井亮 (2019) 『計量経済学』有斐閣
◦Foster Provost, Tom Fawcett (2014) 『戦略的データサイエンス入門―ビジネスに活かすコンセプトとテクニック』O’Reilly Japan
◦金本拓 (2024) 『因果推論ー基礎から機械学習・時系列解析・因果探索を用いた意思決定のアプローチー』, オーム社
◦八谷大岳 (2020) 『ゼロからつくるPython機械学習プログラミング入門』講談社