この記事では、機械学習におけるタスク別の主な手法について、その概要や特徴を解説します。
<目次>
タスク別の主な機械学習手法
機械学習が解く問題のことを「タスク」と呼びますが、機械学習においては、タスクの種類によって適切な手法(学習モデル)を選択することが重要です。タスクの種類ごとの主な手法には以下のようなものが挙げられます1。
| タスクの種類 | 典型的なユースケース | 主な機械学習手法 |
| 予測 | 需要予測や購入確率の予測 | 線形回帰、ロジスティック回帰、GBDT、ランダムフォレスト、ニューラルネット |
| 分類 | 優良顧客の判別 | ロジスティック回帰、GBDT、ランダムフォレスト、ニューラルネット |
| クラスタリング | 属性が似たユーザーの分類 | K-means |
| 行列分解 | 商品のレコメンデーション | Matrix Factorization |
| 次元削減 | データの可視化 | 主成分分析 (PCA) |
| 時系列 | 商品の需要予測 | ARIMA |
このうち、ロジスティック回帰やブーストツリー、ランダムフォレスト、ニューラルネットなどは予測・分類の両方のタスクで使用することができ、正解データ(ラベル)をもとに学習を行う教師あり学習に分類されます。
一方、K-meansや主成分分析 (PCA)は、正解データがない状態で学習を行う教師なし学習に分類されます。以下では、各手法の概要や特徴を解説します。
各手法の概要と特徴
予測・分類タスク
線形回帰
ある変数を他の変数で説明する分析を「回帰分析」と呼びますが、線形回帰は以下の式によって表されるモデルです。なお、「線形」とは、関数f(x)が、変数x1やx2の値の足し算として表現できることを意味します。
例えば、ある寄付者がどのくらいの金額を寄付してくれるかを、寄付者の年齢と収入をもとに予測するケースでは、正解ラベルをもとに以下のような線形回帰モデルを学習し、最も精度の高い予測を行う各wの値を求めます。
なお、機械学習における過学習を回避するための重要な考え方に正則化 (regularization)がありますが、L1正則化を行う線形回帰モデルのことをLasso回帰、L2正則化を行う線形回帰モデルのことをRidge回帰と呼びます。
線形回帰の特徴:
- 予測タスクに使用される。
- 計算が高速で、非常に大きいデータセットや高次元のデータに適用できる。
- 後述するGBDTやニューラルネットに比べて精度は劣ることが多い。
- 非線形性や特徴量間の相互作用を表現するには、新たな特徴量の作成が必要。
ロジスティック回帰
ロジスティック回帰は、線形回帰にロジスティック(シグモイド)関数を適用し、予測値が取る範囲を0~1に制限することで、確率の予測を可能とするモデルです。以下のような式で表現されます。
ここで p+(x) は、推定の対象としている事象が起こる確率、1-p+(x) はその事象が起こらない確率を表します。
線形回帰モデルでは、 f (x) の値はxの値に応じて-∞(マイナス無限)から+∞(プラス無限)の間の値を取りますが、実際の確率は最小0~最大1の間の値となるはずです。また、オファーに応じる確率などは、線形回帰モデルで表現される形で単調に上昇または低下していくのではなく、ある点を境に急激に上昇(または低下)すると考えられます。
ロジスティック回帰は、線形回帰モデルで得られる値を、「確率」を表す別の表現方法に変換することで、これらの問題点を解決する方法です。

作成:Intelligence In Society
ロジスティック回帰の特徴:
- 主に分類タスクに使用される。
- 計算が高速で、非常に大きいデータセットや高次元のデータに適用できる。
- 後述するGBDTやニューラルネットに比べて精度は劣ることが多い。
- 非線形性や特徴量間の相互作用を表現するには、新たな特徴量の作成が必要。
ロジスティック回帰についての詳細は、以下の記事をご覧ください。
GBDT(勾配ブースティング決定木)
GBDT(Gradient Boosting Decision Tree:勾配ブースティング決定木)は、複数の決定木(木構造を使ったデータの分割方法)の集合によるモデルで、ブースティングと呼ばれるアンサンブル学習手法です。決定木を直列に並べ、2本目以降の決定木では目的変数と既に作成した決定木による予測値の差に対して学習し、少しずつ予測を修正していきます。
木を増やすに従いモデルの精度が高まっていくため、新たに作成される木の最終的な予測におけるウェイトは徐々に小さくなります。最終的な予測値は、予測対象データがそれぞれの決定木で属する葉の出力値(予測の修正量:前ステップまでの予測に対して上乗せ・差し引きする値)の和として算出されます。
他のモデルに比べて高い精度が得やすいことに加えて、欠損値をそのまま扱える、特徴量に対して標準化などの必要がない、といった実装面での使いやすさから、最も広く使用されるモデルの一つです。

金本(2024)を参考に、Intelligence In Society作成
GBDTの特徴:
- 高い精度が得やすい
- 実装面で使いやすい(欠損値をそのまま扱える、標準化などの必要がない)
- 予測が高速で、メモリ使用量が小さい
- ランダムフォレストに比べて過学習の影響を受けやすい
ランダムフォレスト
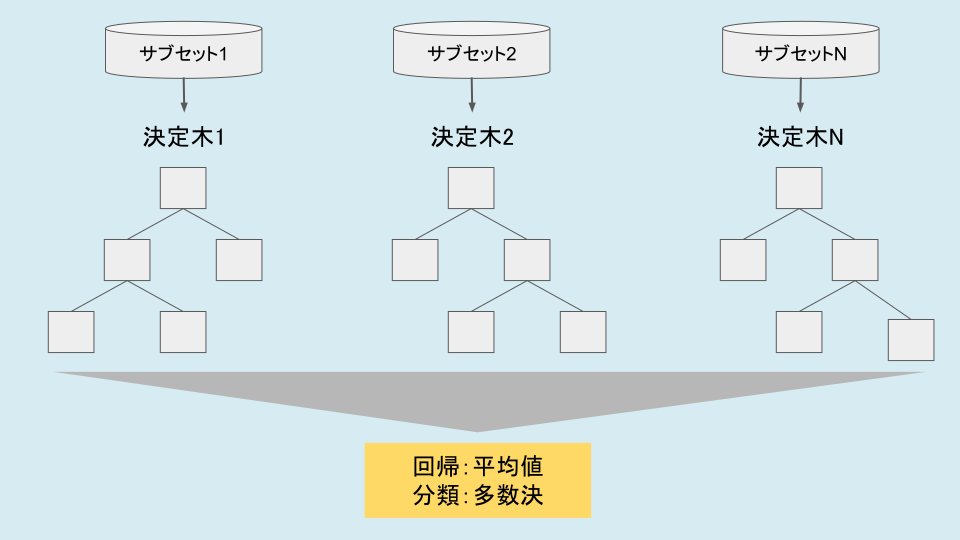
GBDTが決定木を直列に並べるモデルであったのに対して、ランダムフォレスト (Random Forest) は決定木を並列に並べて学習を行うモデルで、バギングと呼ばれるアンサンブル学習手法です。
ランダムフォレストでは、各決定木の構築の際に、ブートストラップサンプリングによって学習データの一部をサンプリングします。個々の決定木は、サンプルリングされた少しずつ異なるサブセットに対して学習を行います。
また、モデルの分岐を作成する際にも、特徴量の一部のみをサンプリングして抽出することで、個々の決定木が特徴量の異なるサブセットに対して分岐を行います。
このように、決定木の構築過程で乱数によるサンプリングを導入し、個々の決定木が互いに異なるようにすることで、各々異なる方向に適合したモデルを作成します。そして、回帰であればその結果の平均、分類であれば多数決を取ることで、過学習を回避しながら予測性能の向上を実現します。
金本(2024)を参考に、Intelligence In Society作成
ランダムフォレストの特徴:
- GBDTに比べて、過学習の影響を受けにくい。
- 実装面で使いやすい(欠損値をそのまま扱える、標準化などの必要がない)。
- 高次元の疎なデータには適さない。
ニューラルネット
ニューラルネットは、テーブルデータにおいてよく使用される多層パーセプトロン (multilayer perceptron:MLP) と呼ばれる比較的簡単な構造や、特定のアプリケーションに特化し、より複雑な構造を持つディープラーニング(深層学習)など、多くのバリエーションが存在します。
基本的なモデルであるMLPは、上述の線形モデルを拡張し、線形モデルの計算を複数回行って最終的な予測値を出すものと捉えることができます。線形モデルは入力 (x) →出力 (y) のみの構造であるのに対して、MLPは入力と出力の間に2~4層程度の中間層を作ります。そして、まず入力層→中間層の計算を行い、その値をもとに中間層→出力層の計算が行われます。

作成:Intelligence In Society
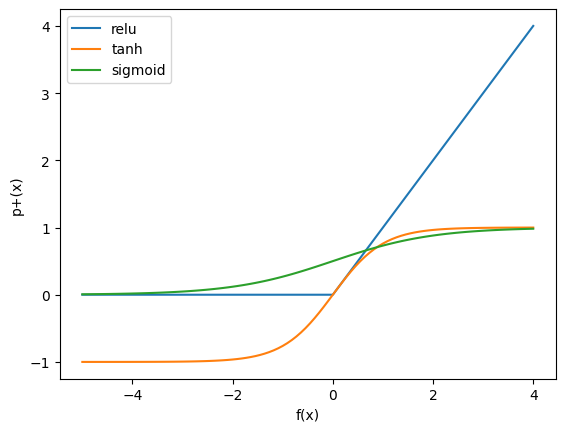
また、線形モデルよりも複雑な関数の学習を可能にするため、MLPでは中間層の計算結果に対して非線形関数(活性化関数)を適用します。代表的なものにReLU (Rectified Linear Unit) がありますが、これはゼロ未満の値をゼロに置き換える(ゼロ以上の値はそのまま)ことで、より複雑なパターンの学習を可能にします。
作成:Intelligence In Society
ニューラルネットの特徴:
- 高い精度が得やすい。
- 非常に複雑なモデルを作ることで、より精度を高めることができる。
- 欠損値の処理や標準化などの対応が必要。
- パラメータの設定に影響を受けやすい。
予測・分類以外のタスク
K-means
クラスタリング(クラスター分析)は、類似しているデータを「クラスター」呼ばれるグループに分割し、データの要約や、クラスターごとの異なる処理を行うための機械学習手法です。
特に、多くの属性を持つ大規模なデータに対してよく用いられる手法で、例えば、あるECサイトの会員属性(年齢、性別、家族構成など)に紐づいた購入履歴データに対してクラスタリングを行うことで、会員を「節約志向型」「ブランド志向型」「流行敏感型」「堅実消費型」などのグループ(クラスター)に分けることができます。
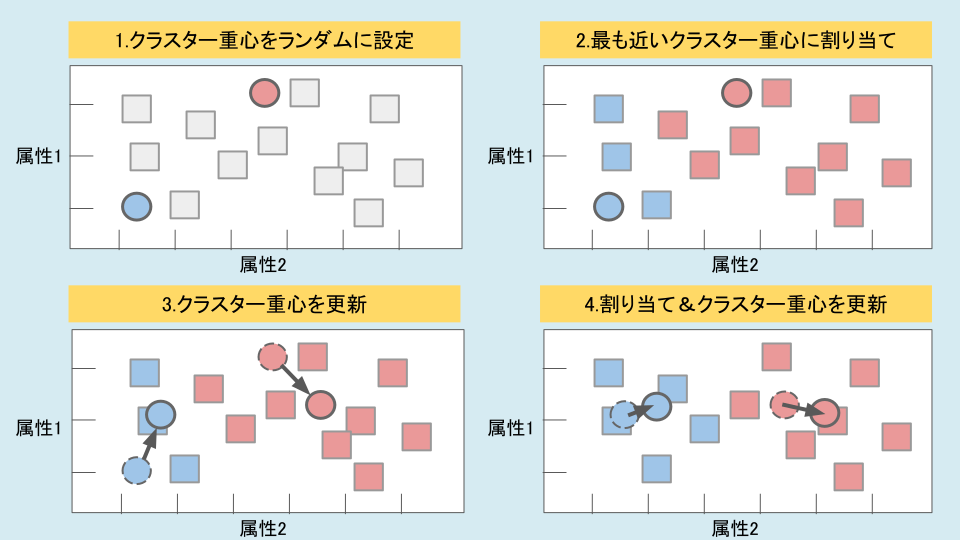
クラスタリングの代表的な手法であるK-means(K平均法)は、クラスターの平均(重心)を用いて、事前に設定したK個のクラスターにデータを分割する方法です。具体的には以下の手順でクラスタリングを行います。
- まず、ランダムにK個のクラスターの中心(クラスター重心)を選択する。
- 各データを最も近いクラスター重心に割り当てる。
- 各クラスターに属するデータの平均を出し、それを新しいクラスター重心とする。
- 上記2~3を、クラスター重心が動かなくなるまで繰り返す。
作成:Intelligence In Society
クラスタリングの特徴:
- アルゴリズムが理解しやすく、大規模なデータにも実施可能。
- クラスター重心を用いてクラスターの特徴を表現できる。
- クラスターの数を事前に設定する必要がある。
- 複雑な形状のクラスターを判別することはできない。
Matrix Factorization
レコメンデーションを行う際に使われる最も代表的な手法の一つが、Matrix Factorization(行列分解)です。この手法は、Netflixが開催した機械学習コンテスト(ユーザーが映画をどう評価するかを予測するもの)で使用されたことで広く活用されるようになりました2。
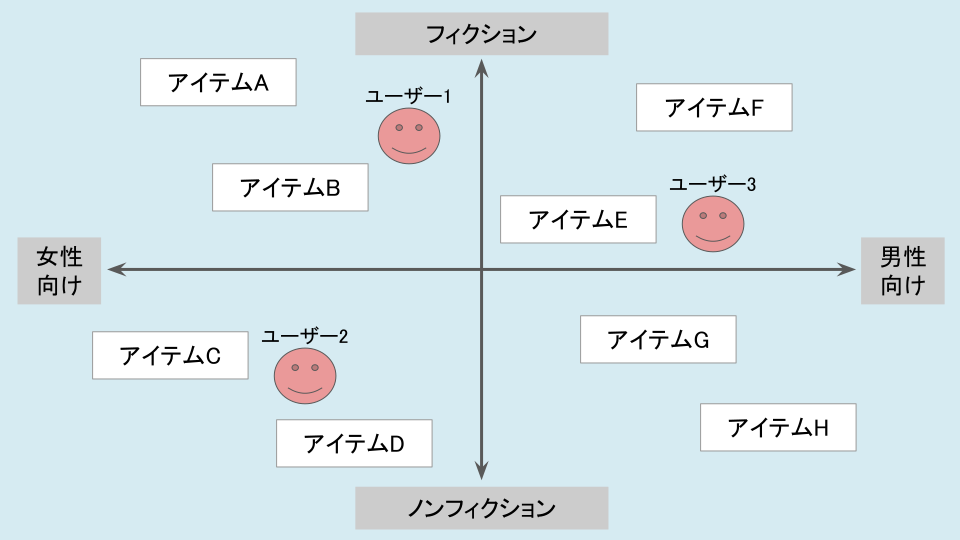
Matrix Factorizationでは、ユーザーとアイテム(映画や商品)をそれぞれ複数の「潜在的な特徴」(フィクションorノンフィクション、男性向けor女性向け、など)で表現します。ユーザーとアイテムは潜在的次元を使った特徴ベクトルとして表現され、ユーザーにとって最も類似度が高いアイテムが、そのユーザーの好みに最も合うものとして選ばれます。
特徴ベクトルは、ユーザーのアイテムに対する評価データを行列として扱い、これを行列分解することで得られます。そして、ユーザーとアイテムの類似度の計算をこのベクトルの内積によって行うことで、ユーザーがまだ評価していないアイテムについても、その評価結果を予測し、レコメンドを行うことが可能となります。
※i はアイテム、qi はi がある特徴をどの程度持っているか、を表す。
※u はユーザー、pu はu がある特徴を持つアイテムにどの程度興味があるか、を表す。
作成:Intelligence In Society
Matrix Factorizationの特徴:
- 高精度かつ省メモリ。
- 拡張性に優れ、複数のデータソースや動的な要素を統合できる。
- 読了有無や視聴履歴などの暗黙的な情報も利用できる。
- 属性情報を加えることで、新規ユーザーなどにも対応できる。
主成分分析 (PCA)
主成分分析 (principal component analysis : PCA) は、最も代表的な次元削減の手法です。次元削減とは、4次元以上などの高次元なデータを、2次元や3次元の人間が理解しやすい次元に変換し、視覚的に表現可能な状態にすることを指します。
主成分分析では、多次元のデータに対して分散の大きい方向(主成分)から順番に軸を取り直すことで、より少数の主成分で元のデータを表現します。主成分が一つ(1次元)の場合は直線、2つ(2次元)の場合は平面として表現されますが、この直線や平面は、各データと正射影した点との残差の二乗平均を最小化するものとして求められます。

八谷 (2020)をもとに、Intelligence In Society作成
上図は、主成分分析と回帰分析の違いを表したものです。主成分分析と回帰分析は、どちらも平均二乗誤差を最小化するように目的関数が設定される一方、その目的と残差の取り方に違いがあります。
回帰分析
目的:縦軸の値を予測すること
残差:直線とデータ点の間の縦(y)軸の距離に対応
主成分分析
目的:データ点を表す低次元の直線や平面を求めること
残差:直線とデータ点の距離に対応
主成分分析の特徴
- 次元削減によりデータの視覚的理解が可能。
- 新たな特徴量の抽出方法としても利用できる。
- 使用の際は、各変数が正規分布に従うという仮定が必要。
ARIMA
ARIMAモデル(Auto Regressive Integrated Moving Average:自己回帰和分移動平均モデル)は、時系列データをもとに将来における商品の需要予測などを行う手法です。なお、時系列データとは、時間の経過に沿って連続的または定期的に記録されるデータのことを指します。
時系列データに対する予測では、過去のデータが現在のデータに与える影響や、周期的な変動などを加味したモデルが必要となります。ARIMAは、時系列データに対する予測において最も広く利用されているモデルの一つです。
ARIMAは以下の3つの部分から構成されます。
ある時点のデータを、それ以前のデータの線形結合によって推定する。
※p次の自己回帰モデル。αは定数項、βはパラメータ、εはホワイトノイズを表す。
平均値の時間的変動(トレンド)を排除するために、過去との差分を取る。差分を取る回数(階差)をdで表す。
移動平均によって、過去の予測誤差(ズレ)の傾向を使って現在の予測を修正する。
※q次の移動平均モデル。αは定数項、θはパラメータ、εはホワイトノイズを表す。
これら3つを組み合わせることによってARIMAモデルは構成されます。また、階差dの時系列をp次のAR,q次のMAに適用したARIMAモデルは、ARIMA (p, d, q) と記載されます。
ARIMAの特徴:
- 構造がシンプルで、過学習の影響を受けにくい。
- トレンドがあっても、トレンドを除去することで予測を行える。
- トレンドを除去できないデータには使用できない。
ここまで、機械学習におけるタスク別の主な手法について、その概要や特徴を解説しました。
当記事に関連するトピックについての詳細は、以下のページをご覧ください。
また、機械学習に関する全ての記事は以下のページからご覧いただけます。
注記・出典:
1. 饗庭、他 (2025) をもとに作成
2. Koren, Bell and Volinsky (2009)
参考文献:
◦饗庭秀一郎、他 (2025) 『改訂新版 Google Cloudではじめる実践データエンジニアリング入門』技術評論社
◦西山慶彦・新谷元嗣・川口大司・奥井亮 (2019) 『計量経済学』有斐閣
◦Foster Provost, Tom Fawcett (2014) 『戦略的データサイエンス入門―ビジネスに活かすコンセプトとテクニック』O’Reilly Japan
◦Andreas C. Muller、Sarah Guido (2017)『Pythonではじめる機械学習―scikit-learnで学ぶ特徴量エンジニアリングと機械学習の基礎』O’Reilly Japan
◦門脇大輔,阪田隆司,保坂桂佑,平松雄司 (2019)『Kaggleで勝つデータ分析の技術』, 技術評論社
◦金本拓 (2024) 『因果推論ー基礎から機械学習・時系列解析・因果探索を用いた意思決定のアプローチー』, オーム社
◦Koren, Bell and Volinsky (2009) “Matrix Factorization Techniques for Recommender Systems.” Computer, vol. 42, no. 8, pp. 30-37
◦八谷大岳 (2020) 『ゼロからつくるPython機械学習プログラミング入門』講談社