この記事では、半構造化/非構造化データについて、その意味や特徴、構造化データとの違い、活用における課題と構造化データへの変換方法を、具体例をもとに解説します。
<目次>
半/非構造化データとは?データ種別の3分類
データ活用基盤が取り扱うデータは、その「構造化の程度」によって3種類に分類することができます。最も一般的な、ExcelやRDB(リレーショナルデータベース)などの2次元の表形式で表現されるデータが構造化データと呼ばれるのに対して、それ以外の形式のデータは半構造化データや非構造化データと呼ばれます。
それぞれのデータ種別がどのようなものであるかは、以下のように整理することができます。
| データ種別 | どのようなデータを指すか | データ形式の例 |
| 構造化データ | 2次元の表形式になっているか、行列への変換が容易なデータ構造を持つ。 | Excel、CSV、RDB、固定長データなど |
| 半構造化データ | データに一定の規則性があり、表形式の構造化データに比較的容易に変換できる。 | JSON、XML、HTMLなど |
| 非構造化データ | データ内に区切りや規則性がなく、2次元表形式データへ変換できない。 | 文章、PDF、音声、画像、動画など |
島田・藪本(2025)をもとに作成
構造化データ
構造化データは、2次元の表形式になっているか、行列への変換が容易なデータ構造を持っており、データの構造が事前に定義されているデータです。SCMやERP、CRMなど業務ソフトのデータベースで広く使用されています。
主なデータ形式には、Excel、CSV、RDB(リレーショナルデータベース)、固定長データなどがあり、データ構造が決まっていることから、データに対する検索や分析が容易に行えるメリットがあります。そのため、後述するように、半構造化データや非構造化データデータは、構造化データに変換した上で、分析用のデータとしてデータウェアハウス(DWH)などに保管されることが一般的です。
半構造化データ
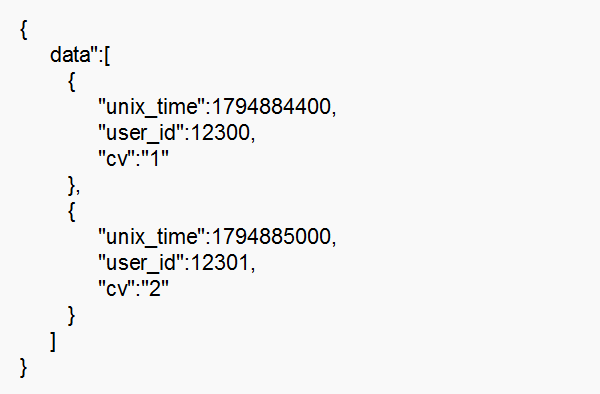
半構造化データは、データに一定の規則性があり、表形式の構造化データに比較的容易に変換することが可能なデータです。ただし、構造化データと違い、半構造化データは事前にデータ構造が定義されていないため、その一部分を見ただけでは2次元表形式データへの変換が可能か判断することができません(通常は、全データや十分大きなサンプルをもとに構造の解析を行う必要があります)。
半構造化データの代表的なデータ形式としては、JSONやXMLなどのテキスト形式のデータやHTMLなどが広く使用されています。これらのデータ形式は、非構造化データの一種でありながら、その記述が一定のルールや規則性に基づいたものであるため容易に構造化データへの変換が可能であることが大きな特徴です。
一般的には、データレイクなどに保管された半構造化データを加工し、構造化データに変換した上でデータウェアハウスに格納され、分析や活用が行われます。
非構造化データ
非構造化データは、データ内に区切りや規則性がなく、2次元の表形式データへ変換することができないデータです。文章、PDF、音声、画像、動画などが非構造化データに分類され、半構造化データと同様に、一般的にはデータレイクなどにファイル形式で保管されます。
半構造化データが一定の規則性を持っているのに対し、非構造化データは規則性を持たないデータのため分析が難しく、機械学習などを通じて「規則性を見つける」というアプローチが必要です。画像であれば画像解析、文章であれば形態素解析やTF-IDFを行うことで非構造化データにその特徴となる情報(メタ情報)を付与し、それを構造化データとして格納することで分析が可能となります。
各データ種別の比較
これら3種類のデータ種別の特徴をまとめると、以下のようになります。
| 比較軸 | 構造化データ | 半構造化/非構造化データ |
| データの性質 | 定量的 | 定性的 |
| データモデル | データ構造が事前に定義され、データ保存後の変更は困難 | データ構造に関する特定の枠組みや定義を持たない |
| データベース | SQLベースのRDBなどを使用 | NoSQLデータベースなどを使用 |
| 検索・分析 | 容易に実施できる | 構造化されていないため困難 |
| 保管場所 | データウェアハウスが一般的 | データレイクが一般的 |
大川(2023)をもとに作成
構造化データは、データ構造が事前に定義されており、データベースにはMySQLやPostgreSQLなどのSQLベースのRDBなどが使用されます。データ構造が定義されていることから、検索や分析を容易に行うことができ、データ活用基盤では加工済みのデータがデータウェアハウスに保管されることが一般的です。
一方、半構造化/非構造化データは、データ構造に関する特定の枠組みや定義を持たず、データベースにはMongoDBなどのNoSQLデータベース(RDB以外のデータベースの総称)が使用されます。データ構造が定義されていないため、検索や分析を行うことが難しい課題があり、データ活用基盤では未加工のままのデータがデータレイクに保管されることが一般的です。
活用における課題と構造化データへの変換
半/非構造化データの活用における課題
組織が、保有するデータを効果的に分析・活用し、データから価値を生み出すには、様々なデータソースから収集したデータを分析が可能な状態に加工・統合し、高品質で検索・分析が容易な状態のデータがデータウェアハウスに格納されていることが重要です。
一方、企業が扱うデータの約8割が半/非構造化データと言われており、データ活用基盤に投入されるデータの大半が半/非構造化データであるケースが一般的となっています。そのため、半/非構造化データを分析・活用が可能な構造化データに変換することは、データ活用基盤の主要機能の一つである「加工」のプロセスにおける重要なテーマとなります。
半構造化データの構造化データへの変換
半構造化データの構造データ化において重要となるのが、データ構造の2次元化です。WEBサービスなどでは、3次元以上のデータをJSON形式などで出力する形式が広く使われていますが、多次元構造のままでは分析が困難であったり、処理が複雑化するなどの課題があります。そこで、多次元構造のデータを2次元の構造化データに変換することで、より容易に分析を行うことができます。
以下は前出のJSON形式のデータを、多次元構造から2次元の構造化データに変換する例です。
(元のJSON形式のデータ)
(変換後の2次元の構造化データ)
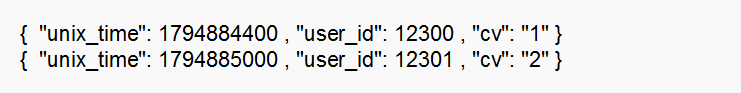
データ構造の2次元化と合わせて重要となるのが、データの標準化処理です。上記ではユーザーIDを示すキーが「user_id」ですが、仮に社内の他のデータでは「userid」となっている場合、2つのデータを繋ぎ合わせて分析するには、キーの標準化を行い同じ対象を指すデータを統一したキーに揃える必要があります。
また、上記ではcvの値がダブルクォーテーション (“”) で囲まれ、数値ではなく文字列として定義されているため、 cvの合計を計算したい場合などは、数値型への変換によるデータ型の標準化が必要です。他にも、unix_time(UNIX時間)を日本時間に変換する値の標準化など、データを分析可能な状態にするための標準化処理が、データ構造の2次元化と合わせて重要となります。
非構造化データの構造化データへの変換
一定の規則性を持つ半構造化データに対して、規則性を持たない非構造化データは同様の次元削減による構造データ化は難しく、機械学習などを通じて規則性を見つけ、それを特徴(feature)として非構造化データに付与することで、構造化データに変換することが必要となります。
機械学習を使って文章から特徴を抽出し、それを構造データに変換する事例については、以下の記事をご覧ください。
また、近年のクラウドベースのデータプラットフォームでは、非構造化データに対する機械学習処理をデータウェアハウス上などで容易に行うことができるサービスも提供されています。例えばGoogleのBigQueryでは、Vision APIによる画像へのタグ付け、Embedding APIによるテキストデータの特徴ベクトル化などを行うことが可能です。
ここまで、半構造化/非構造化データについて、その意味や特徴、構造化データとの違い、活用における課題と構造化データへの変換方法を解説しました。
当記事に関連するトピックについての詳細は、以下のページをご覧ください。
また、データ活用、データ分析、機械学習に関する全ての記事は以下のページからご覧いただけます。
参考文献:
◦島田雅年・藪本晃輔 (2025) 『データプラットフォーム技術バイブル』株式会社マイナビ出版
◦大川真輝 (2023) 『DX時代のデータマネジメント大全 ― DX、データドリブン経営、データ利活用から理解する ―』株式会社翔泳社
◦饗庭秀一郎、他 (2025) 『改訂新版 Google Cloudではじめる実践データエンジニアリング入門』技術評論社